こんにちは、Digital Experts でソフトウェアエンジニアをしている仲吉です!
チーム「DIgital Experts」で ICFPC(ICFP Programming Contest) というプログラミングコンテストに参加し、Lightning Round と総合の両方で1位を獲得することができました!メンバーは弊社と丸紅の社員8名、そしてインターン生7名の計15名です。コンテストはオンライン開催ですが、私たちは一丸となって取り組むために温泉のある宿泊施設に集まりました。
Digital Experts として初めて参加した昨年は全体で11位に終わり(参加記)、情報共有の意識付けや、シミュレータなどの環境整備が足りないといった反省点が多く残りました。今年はその課題を個人の頑張りではなく仕組みで解決しようと考え、AIが自律的に情報を共有し、解を作って試せる環境を整えたうえで、誰がどの環境整備に取り組むのかもチーム内で連絡するようにしました。昨年と比べてAIの性能が大きく上がっていたこともあり、この仕組みでAIを効果的に活用できたことが優勝につながったと考えています。
本記事では、AIハーネスの構築や人間とAIの役割分担などを含め、コンテストにどのように取り組んだのかをより具体的にご紹介します!
ICFPCとは
ICFPC(ICFP Programming Contest)は、関数型プログラミングの国際会議 ICFP に合わせて開催されるプログラミングコンテストです。 競技時間は72時間あり、最初の24時間の成績で競う Lightning Round も設けられています。 今年は日本時間で7月24日(金)21時から7月27日(月)21時までの開催でした。
順位表には凍結期間があり、Lightning Round と本戦のそれぞれ終了2時間前から、公式順位表に新しい提出の結果が反映されなくなります。 Lightning Round の凍結は終了2時間後に解除されますが、本戦の最終結果は後日の発表まで分かりません。 そのため、凍結中は他のチームがどこまで改善しているかを見られないまま、最後まで改善を続けることになります。
関数型プログラミングの会議に関連する大会ですが、使うプログラミング言語は自由です。 チームの人数にも上限がなく、今年の公式ルールでは AI エージェントを含むツールの利用も認められています。
毎年少し変わった問題が出題され、アルゴリズムを考えるだけでなく、仕様を理解したり、実験用のツールを作ったりする必要があります。 途中で新しい問題やルールが追加されることもあるため、作った解やツールを使いながら、新しい問題にも対応していきます。単に Lightning Round で勝つための考察や作業だけをしていると、新しい問題に太刀打ちできなくなることもありえます。
コンテストで勝つために必要なことをちゃんと洗い出してからチームで分担して進めると効果的なのも、このコンテストのおもしろいところです!
問題概要
今年のテーマは、Littleman という2次元のプログラミング言語でした。 文字を格子状に並べた盤面に「小人」を置くと、小人が盤面を歩きながら、その場所の命令を実行します。 1ステップは tick と呼ばれ、複数の小人が同時に動きます。
小人は両手とリュック合計3つの整数を持てます。 盤面には壁で囲まれた部屋があり、部屋同士はパイプでつながっています。 パイプを使うと数値を送受信でき、各部屋にいる小人同士はパイプを使って通信を行います。 計算の手順を考えるだけでなく、小人がどこを通るか、どの部屋にデータを送るかまでプログラムとして設計する必要があります。また、パイプをキューのように扱ったりと工夫できる部分もたくさんあります。
下の画像は公式シミュレータで Triangle の解を実行した様子で、赤い「@」が小人です。
小人は下段の左端から右へ進み、入力された数を $n$ として $n^2 + n$ を計算します。
右端で上に曲がり、今度は上段を左へ進みながら2で割り、s 命令で答えを出力パイプへ送ります。
つまり、このプログラムは $n(n+1)/2$ を直接計算しています。
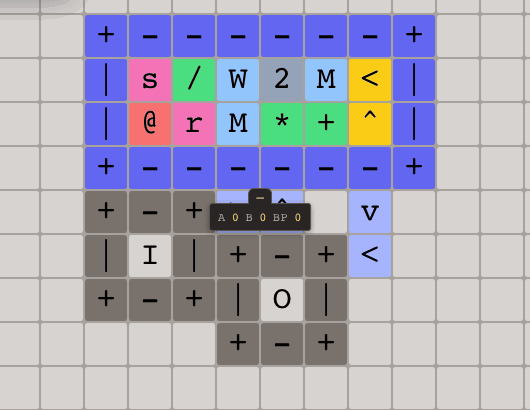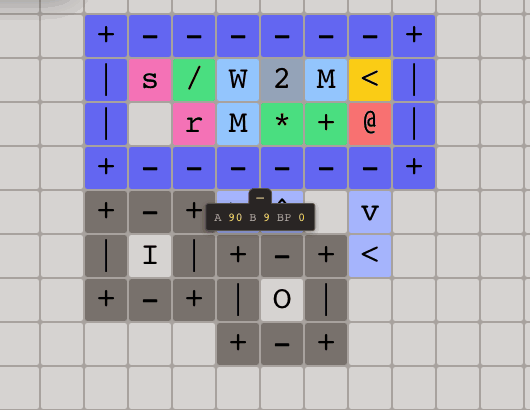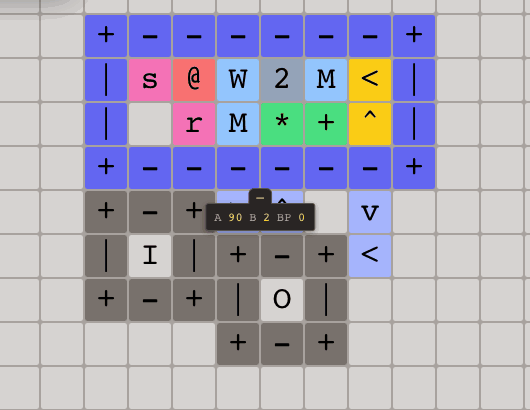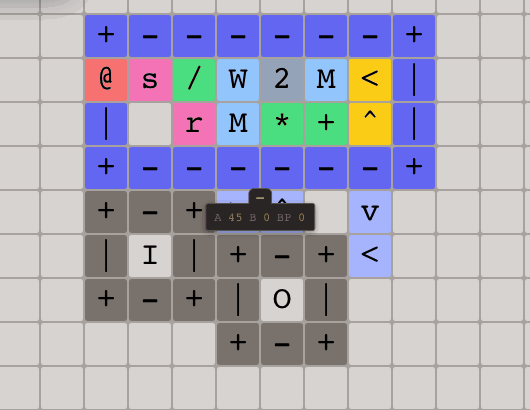
今回のコンテストでは初日から公開されている問題が12問あり、24時間経過時点で4問追加され、最終的には16問の問題をこの言語を使って解くことになりました。 例えば、次のような問題があります。
| 問題 | やること |
|---|---|
| Triangle | 1から入力された数までの整数の和(三角数)を計算する |
| Memory | 指定されたアドレスへの値の書き込みと読み出しに対応する |
| Reverse a List / Sort | 数列を逆順にする、並べ替える |
| Matrix Multiply / Subset Sum | 行列積を計算する、指定された和を作る部分集合を求める |
| Plotter / Snake | 指定された図形やゲームの画面を描画する |
| Little Little Man / Little Little Little Man | Littleman の縮小版の言語を解釈し、実行状態を画面に描く |
正しく動く解ができたら、次は盤面の大きさと実行にかかる時間を改善します。
多くの問題で使われるスコアは、max(盤面の幅, 盤面の高さ)² × 平均tick数 で、小さいほど良い成績になります。
ここで使うのは、幅と高さのうち長い方です。
例えば、100×50の盤面を90×60に変えられれば、面積自体は大きくなっているとしても、実行時間が同じであればスコアが改善します。
逆に、短い方の辺だけを縮めても、盤面サイズによるスコアは変わりません。
そのため、計算の手順が同じでも、小人の移動を減らしたり、部屋を詰めたりすることでスコアを改善できます。 アルゴリズムと盤面の配置の両方を考える、2段階のパズルのような問題でした。
先ほどの Triangle では、小人をグルグルさせることでループを実装できるので $1 + 2 + \cdots + n$ を直接計算させることもできます。 しかし、盤面のサイズを小さくすることを考えると直接 $n(n+1)/2$ を計算した方が効率的です。このように、単に実装するだけではなく、工夫をしながら盤面とステップ数を縮めていくことになります。
総合成績には、各問題でどのくらいテストを通過できたかと、その問題を解けたチームの中で何位であったかが関わってきます。 上の式で計算されるスコアを全問題分足したものではないので、一つの問題を大きく改善すれば総合点も同じだけ増えるというわけではありません。 採点の詳細は公式の Grading ページにまとまっています。
主な戦略
AI活用
ハーネスの整備
コーディングエージェントが自分で解を実行し、その結果を見て改善を続けられるようにしました。 ハーネスの定義は様々かと思いますが、この場では問題を解くための実行環境やツール、作業ルール、その他の情報を供給できるシステムをまとめて ハーネス と呼ぶことにします。
今回用意したハーネスは、各メンバーのコーディングエージェントが協調するための仕組みと、各コーディングエージェントが単独で動く際に便利なツールの2種類です。 全体の構成は、次の図のようになっています。
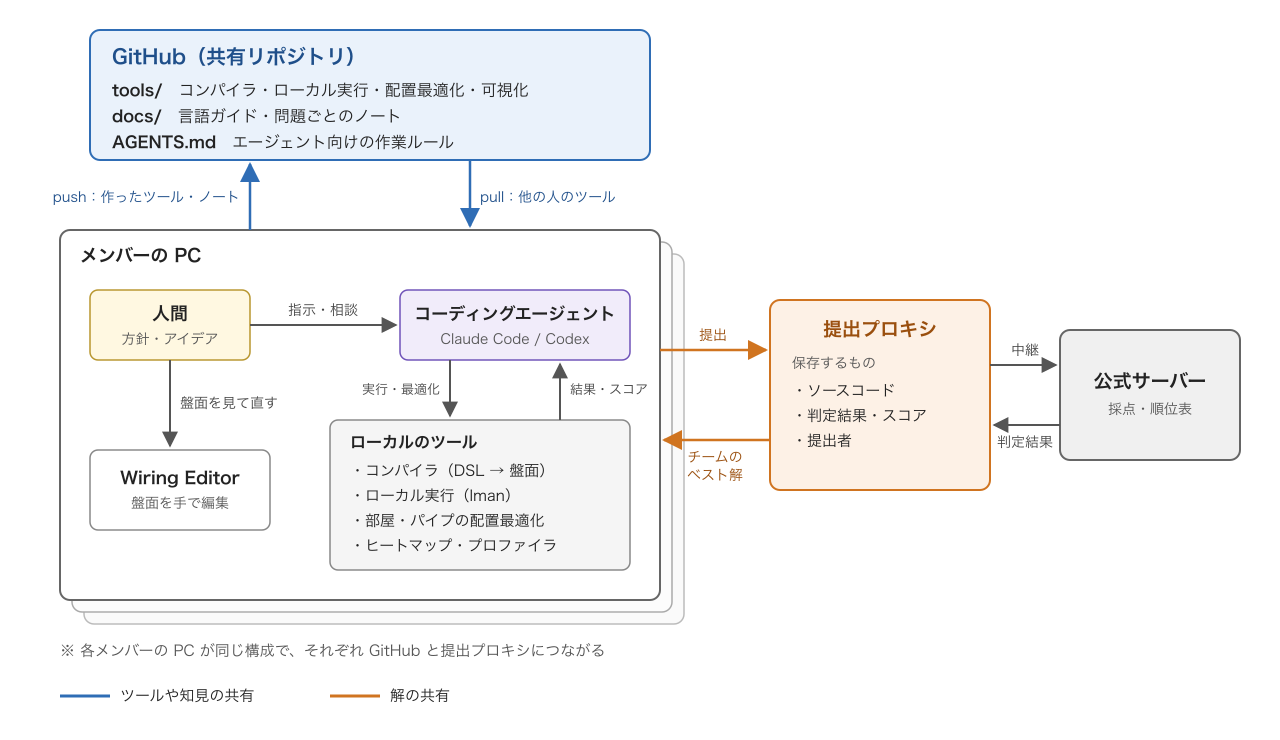
ここに含まれていない部分では、ChatGPT の Pro モードも利用していました。コンテスト中盤からは ChatGPT の Pro モードに各問題の改善をお願いし続けるメンバーがおり、スコア改善へ大きく貢献していました。
協調するための仕組みとしては、主にGitHub リポジトリと提出プロキシを用意しました。GitHub リポジトリでは主に開発されたツールやコアとなる考察、基本的な情報の共有などを行います。
GitHub リポジトリを使えば高得点を取った最新解を皆で共有することもできます。ただ、リポジトリ内の回答プログラムがどんどん増えてしまう、同期漏れが起きる、実際のベスト解がどれなのかわからない、など様々な問題が発生することが予想されます。そこで、提出プロキシを用意しました。
提出プロキシは、公式サーバーに提出するかわりにプロキシに提出することで、各提出のプログラムとスコアが保存され、各問題への提出の取得もできるようなものです。同時に、他チームのスコアを取得し、「順位を上げるため」「1位になるため」に必要な改善幅も常にAIが取得できるようにしておきました。
スコアだけから相手の盤面サイズと tick 数を両方決めることはできません。ただ、盤面サイズは整数なので、tick 数がこちらの解と大差ないと仮定すれば、スコアの式から相手の盤面の長辺がおおよそ見積もれます。相手の実装がわかるわけではありませんが、次に目指すべき盤面サイズの目安になるので、この情報がとても重要になります!その目安を目指して各メンバーのAIが、現在のチームベストを改善しようと試み続ける仕組みが回っていました。逆に、プログラムの配置や圧縮を頑張っても到底届かないようなスコア差がある時には、そのことを考慮して、根本的なアルゴリズムの改善やアイデア出しを人間とAIで行っていました。
自分のチームのスコア情報も他のチームにとって重要な情報となるため、このプロキシから公式サーバーへの提出を一時的にストップし、後でまとめて提出するような潜伏を行えることも大きなメリットになるはずでした。ところが、正式なスコアを早く知りたいことも多く、結局潜伏は行わずに公式サーバーにすぐ反映していました。
エージェントが単独で正しい解を作って改善するためのツールとしては、ローカルの実行環境やコンパイラも整備しました。 Littleman の命令を最初から2次元の盤面に手で並べるのは大変なので、社員がコンパイラを実装しました。擬似言語で変数や配列、ループなどを使って書いた処理から盤面を生成します。最初の24時間の問題では、コンパイラを使わずともとりあえず正解するプログラムをAIが生成できます。しかし、後述するように Lightning Round 終了後に追加された Little Little Man(以下、問題「LLM」)や Little Little Little Man(以下 LLLM)などは AI が直接解を作るのは難しく時間がかかるため、コンパイラをAIが使うことで初期解が比較的早く出てきました。
動く解ができたら、次はスコアを改善するためのツールです。 部屋やパイプの配置を最適化するツールや、命令の実行位置、入出力待ちを可視化するヒートマップなどを作りました。受信待ちの多い部屋や何度も通る経路を見つけることで、どこに時間がかかっているかを調べられます。AIも、そのようなプロファイラの結果を見るとうまく改善できる傾向がありました。
とにかく動かし続ける
一通りの環境ができると、「この解を改善して」と伝えるだけでも、命令の置き換えや配置の調整を試してくれるようになります。 人間が具体的な改善案を思いついていなくてもどんどん改善が進むので、できるだけ止めずに動かし続けるようにしていました。寝ている時間ももったいないので、寝ている間に実験や改善を続けてもらうループを用意しました。ループの間にローカルマシンで改善できたとしても、その間に、他のマシンで動いているAIがより良い解を作成していることがあります。ただ、そんなときも前述のプロキシによって自律的に最新状況を把握し、そこから改めて改善を進めることができます。
こうして改善を重ねると、最初の解と比べて見違えるほどシンプルな解になります。 次の図は、Little Little Little Man でチームが最初に全ケース合格した解と、最終的なチームベスト解を同じ縮尺で並べたものです。
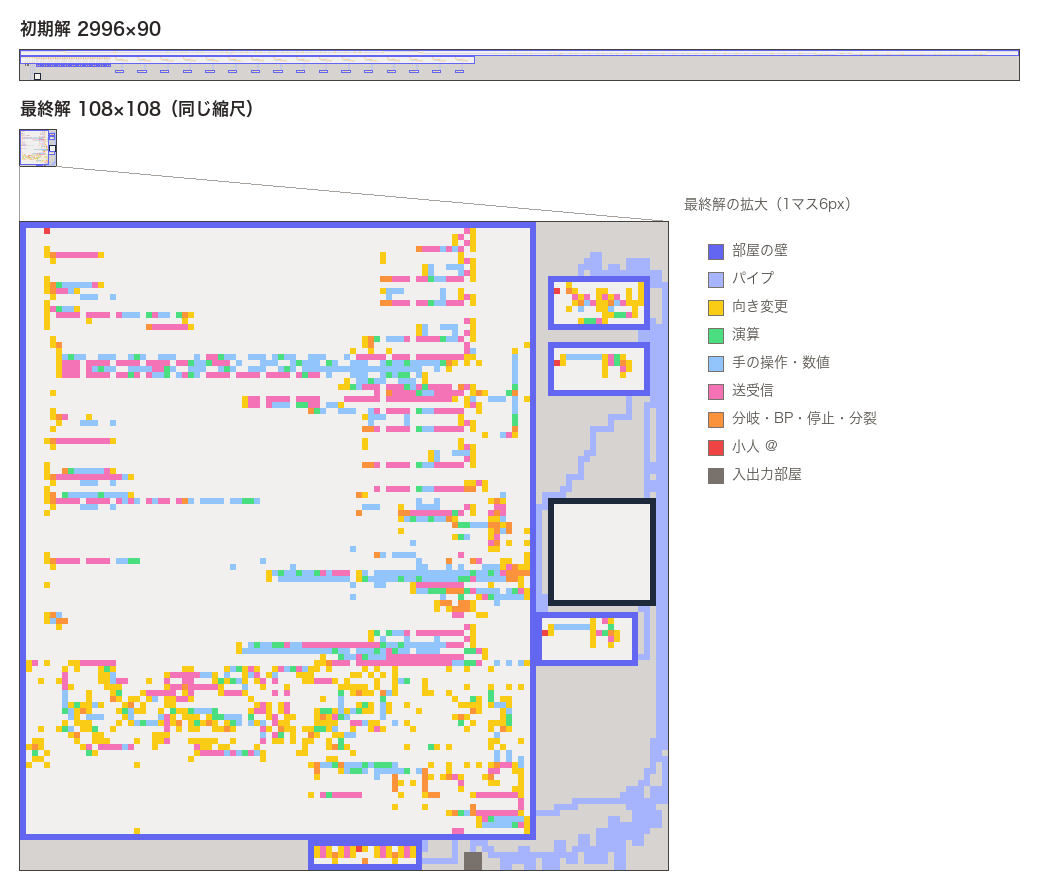
最初の解は2996×90の盤面で、スコアは約48.4兆でした。 横に細長いですが、スコアは長い方の辺で決まるので、2996×2996の盤面と同じ扱いになります。 最終解は108×108で、平均tick数も約83分の1になり、スコアは約7.57億まで下がりました。 最初の解と比べると、約6.4万分の1です!
Little Little Little Man に対するチームベストの推移をグラフにすると、次のようになります。
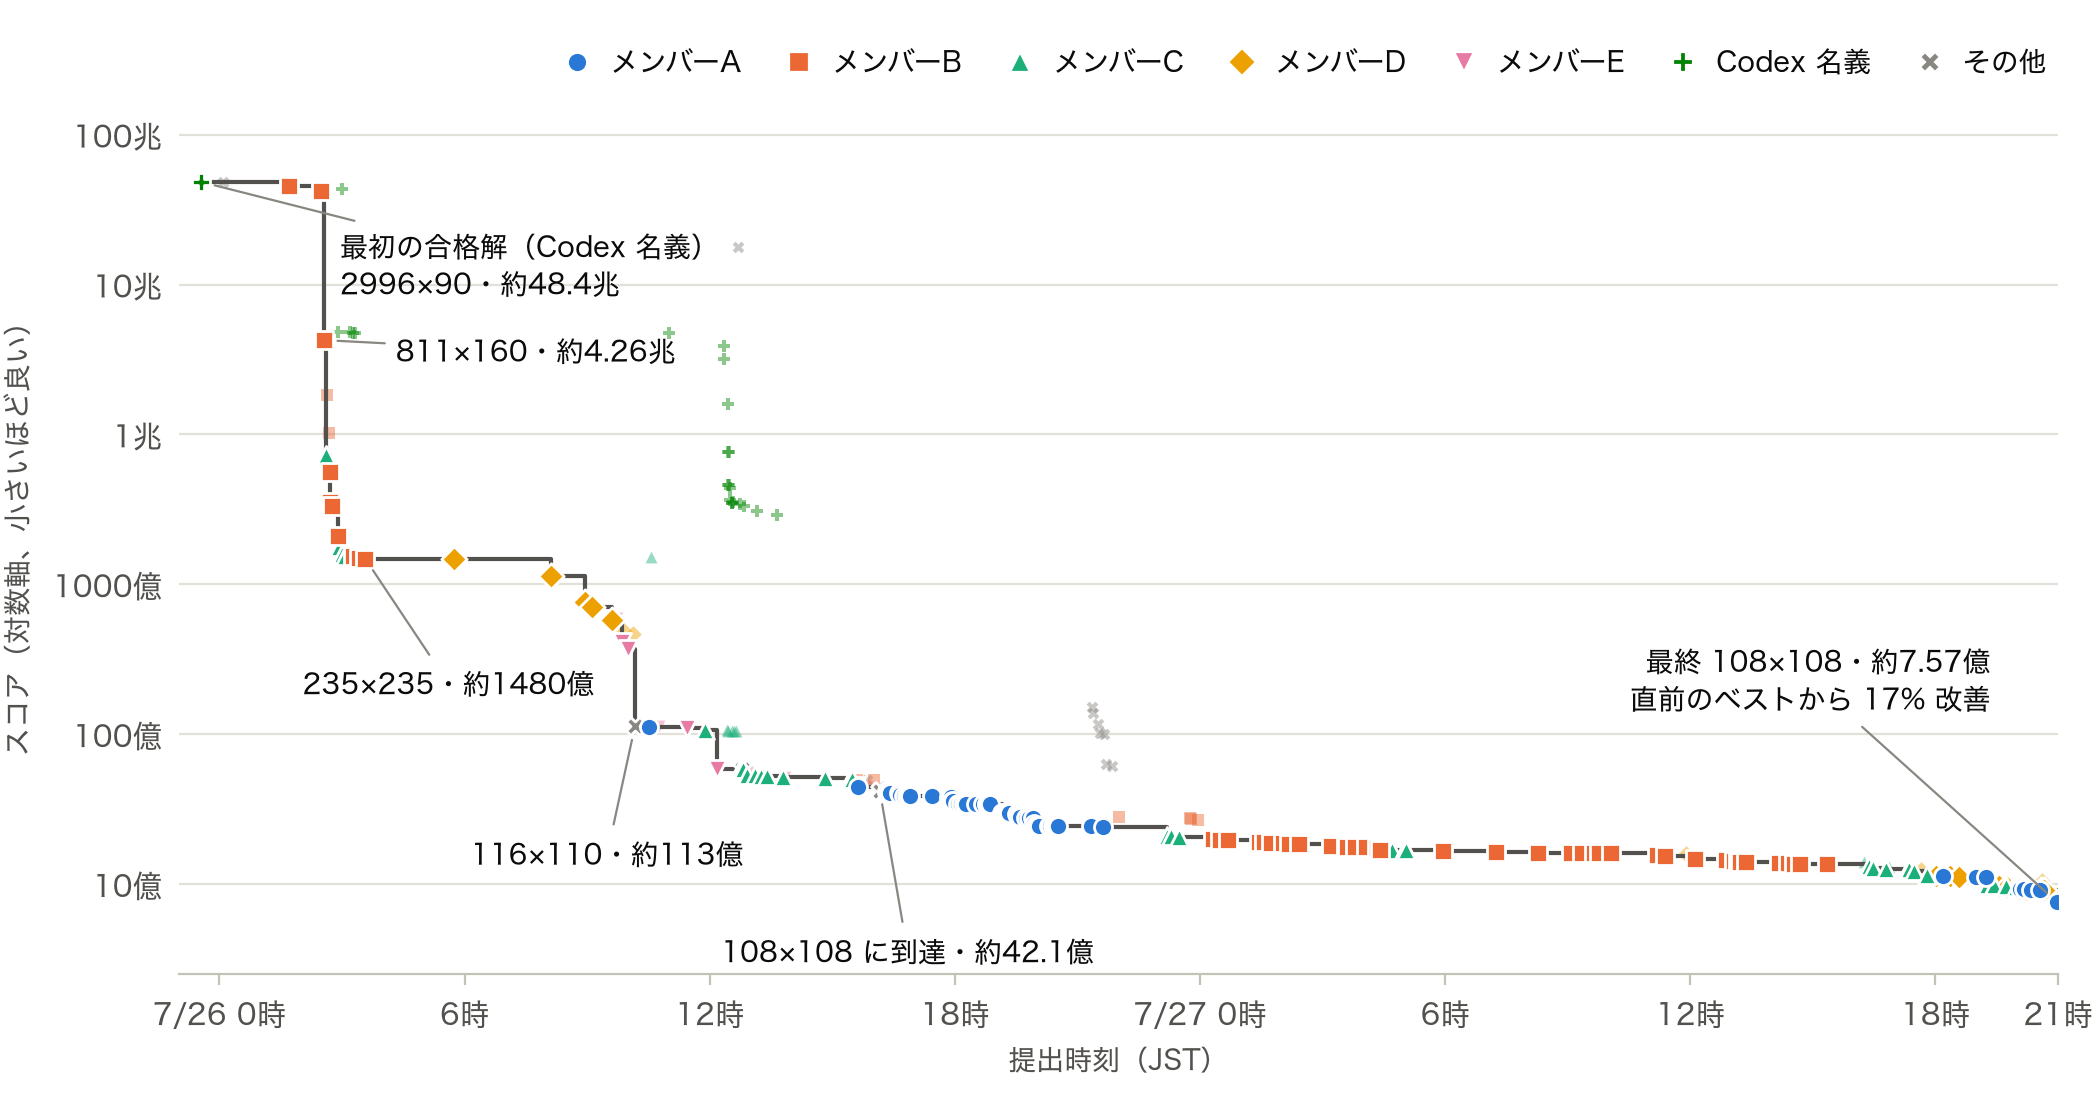
点の色と形は、提出したメンバーを表しています。チームベストの更新は全部で169回ありました。 最初の4時間ほどで盤面は2996×90から235×235まで縮み、7月26日の夕方には108×108の解ができています。 その後は tick 数を中心に削り続けました。この108×108の解(約42.1億)と最終解は盤面サイズが同じで、tick 数の削減だけでスコアを約8割も下げています。
このような改善は他の問題でも行われ、最初に正解が出てからは色々な人がどんどん更新していく仕組みが整っていました。
アイデアを実装して比べる
基本的には、最初にアイデアを出してからはAIに改善をまかせると良いスコアを取れます。しかし、時間も限られているので、パパッと筋の良いアイデアを出して AI に与えることができれば、改善含めてAIにただ任せ続けるよりも有利になります。
色々なアイデアを考える際にも、実装にかかる手間を気にせずに思いついた案を試せることが助かりました。アイデアを思いついたらエージェントに実装してもらい、実現性があるのか、スコアが良くなるのかを確かめます。プログラムの改善だけでなく、コンパイラの改善や、探索アルゴリズムを必要とする問題でもこのように試していきました。
人間の関わり方
人間が1からプログラムを書いて正解まで出したのは、練習問題に加えて2、3問くらいしかありませんでした。
ただ、前述したように、AIを活用できるような環境として何が必要なのかを考え、それぞれの整備を行ったり、AIに指示を出す部分は人間が行っています。また、それ以外にも、以下に示すように配置最適化や解法・アルゴリズムの提案なども行いました。
プログラムを俯瞰で見て改善する
プログラムは二次元のアスキーアートのようなものなので、配線や部屋の配置の調整はエージェントに頼んでも文字列編集でうまく進まなかったり、直感的な改善ができなかったりすることもあります。そこで、人間もビジュアライザを見て、明らかに短縮できる経路や詰められそうな空間を俯瞰的に探しました。
そのために、盤面を手で編集できる GUI エディタも作りました。 公式でもエディタはありますが、配線や配置だけを編集するのに特化した道具として作られ、便利な機能をつけてあります。例えば、部屋を動かしたらパイプが自動で配線され直したりします。このようなツールの開発もやはりコーディングエージェントにお願いしています。
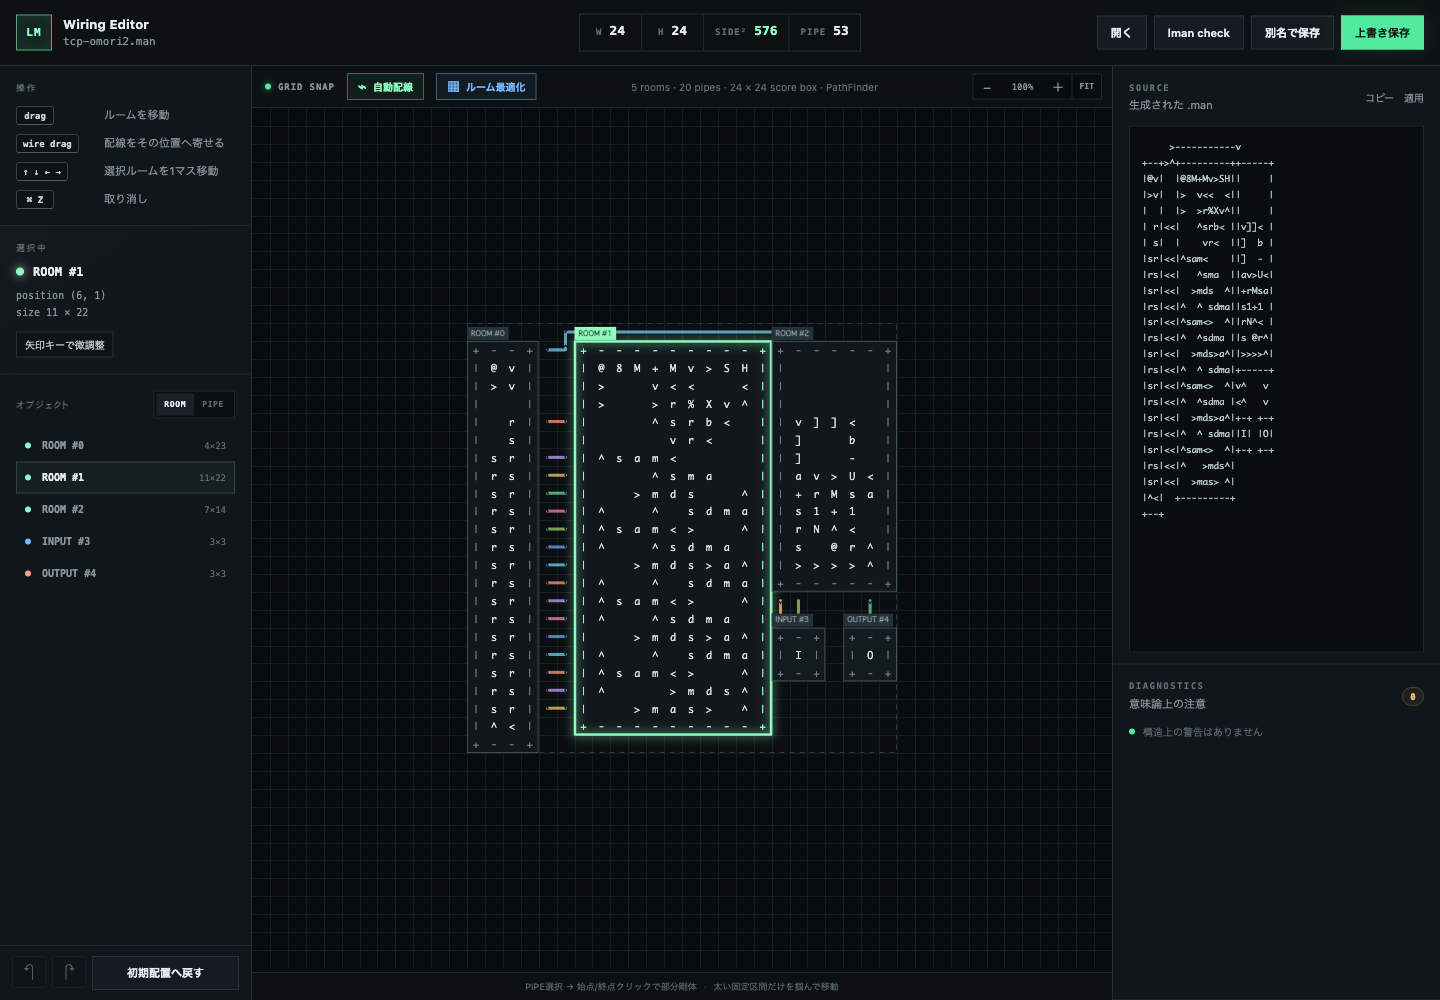
エディタに欲しい機能をチームで出しあったりもしました。 例えば、盤面サイズやスコアの表示、よく使う処理のテンプレートなどの要望が出ていました。
ただ、誰がどのツールを作るかは連絡していたものの、他の人が開発中のツールに手を加えるとコンフリクトが起きるため、それを避けようとしてエディタやその他のツールも徐々に乱立し、統一しきれなかったのは反省点です。その方が戦略の探索幅が広くなるので良いという側面もあるかもしれませんが、トークンや時間の消費がもったいなかったと感じています。
解法・アルゴリズムのアイデア提案
出てきたプログラムの配置をちょっと改善するだけではなく、各問題を解くためのアイデアそのものも人間が出していました。
例えば、Memory という問題は、100個の記憶領域への読み書きに対応する問題です。
値の保存には小人を使うかパイプを使うかのどちらかが必要なのですが、この問題では小人を使う方が効率的でした。盤面に最初から置ける小人は1部屋に1人なので、小人を分裂させる Y 命令を使わない解では記憶領域ごとに小さな部屋を並べることになります。
読み書きの要求を全部の部屋へ一斉に送り、それぞれの部屋が自分のアドレスかどうかを確かめる方式です。
記憶領域用と宛先が自分かをチェックするための部屋で合わせて200個を超え、盤面は118×118になりました。
さらに、24時間経過時点で追加された Y 命令 を使うことで改善できました。
値を保持するために小人の数だけ部屋が必要だったのですが、Y 命令を使えば実行中に部屋の中で小人を増やせるので、一つの部屋に複数の記憶要素をまとめることができます。
ここで、Y 命令を使って部屋をまとめられることや、二分木によって効率的にリクエストを振り分けられることなどは人間が出したアイデアでした。配置についても、4部屋に分けた方が良いことなどは最初からAIに伝えていましたが、その後の最適化はほとんどAI任せでした。
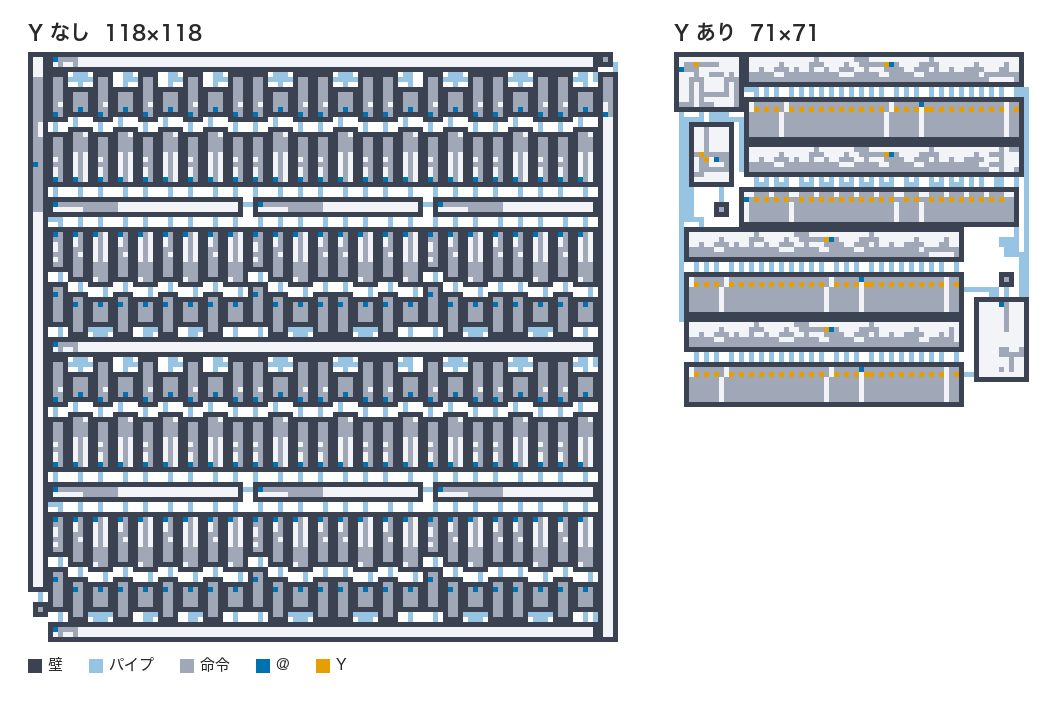
左が Y を使わない解のベスト、右が Y を使った最終解で、同じ縮尺で描いています。
最終的な解では、起動直後に1人の小人が列を歩きながら Y を踏み、1部屋に25人ずつ記憶係の小人を並べます。
これを4部屋に用意して、100個の記憶領域にしています。
リクエストを受け取ったら、連絡係の小人はアドレスのビットを1つずつ見て左右に曲がり、二分木をたどっていきます。 まず下位2ビットで4つの記憶部屋のどれに送るかを決め、残りのビットで25人のうち誰に渡すかを決めます。 この二分木の葉には記憶係の小人1人ずつにつながるパイプがあり、連絡係はそこへ要求を送って停止します。
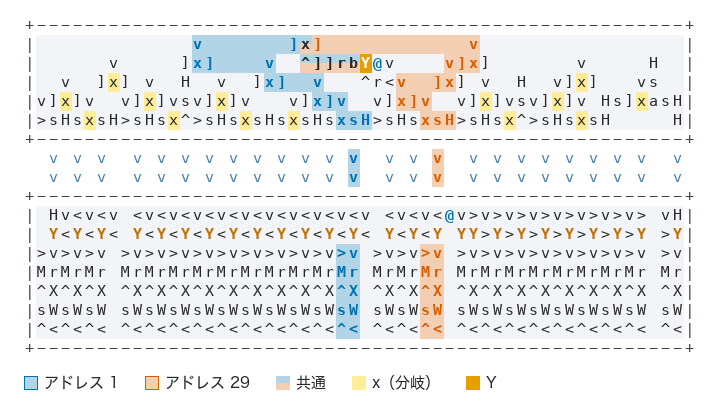
アドレス1と29の読み出しリクエストがたどる経路です。
上が振り分け部屋、下が記憶部屋です。
x は、アドレスのビットによって左右に曲がる命令です。
2つの要求は下位2ビットが同じなので同じ振り分け部屋に来て、その先の x で左右に分かれています。
最終解は71×71で、スコアは Y を使わない解でのベストの約3分の1になりました。
配置の詰めなども重ねた結果なのですべてが Y の効果というわけではありませんが、盤面の作り方は大きく変わりました。
コンテスト中の様子
実際にコンテスト中にどのように取り組んでいたかを時系列でご紹介します。
Lightning Round
7月24日21時にコンテストが始まりました。 問題概要の把握を行って解き始めると同時に、提出や検証のための環境も整えていきました。 24日中には前述の提出プロキシの案が出て、コンパイラや配置最適化ツールの開発も進み、翌日には実行時のボトルネックを調べるプロファイラやヒートマップも使えるようになりました。
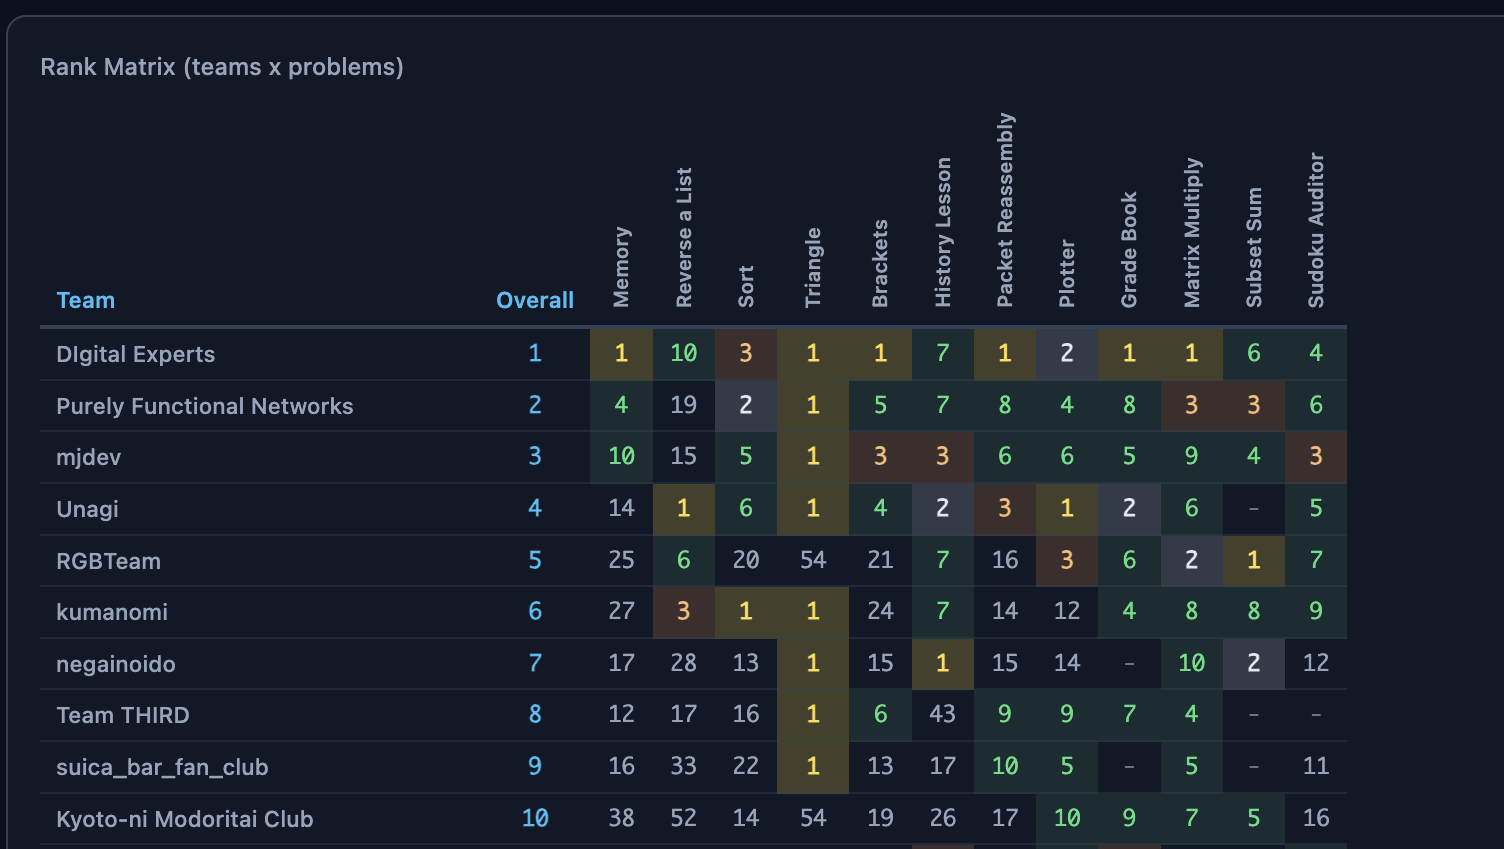
Lightning Round の前半には、上のスクリーンショットのように全体1位となりましたが、競争は激しく、その後他のチームの改善が進むと転落してしまいました。
その後、順位が上がったり下がったりを繰り返し、Lightning Round 終了時点では以下のスクリーンショットのようなスコアになっていました。これは提出プロキシでの情報なのですが、他チームが凍結時点のスコアだとした時の順位が表示されており、他チームも改善していると1位ではない可能性が十分にある状況でした。
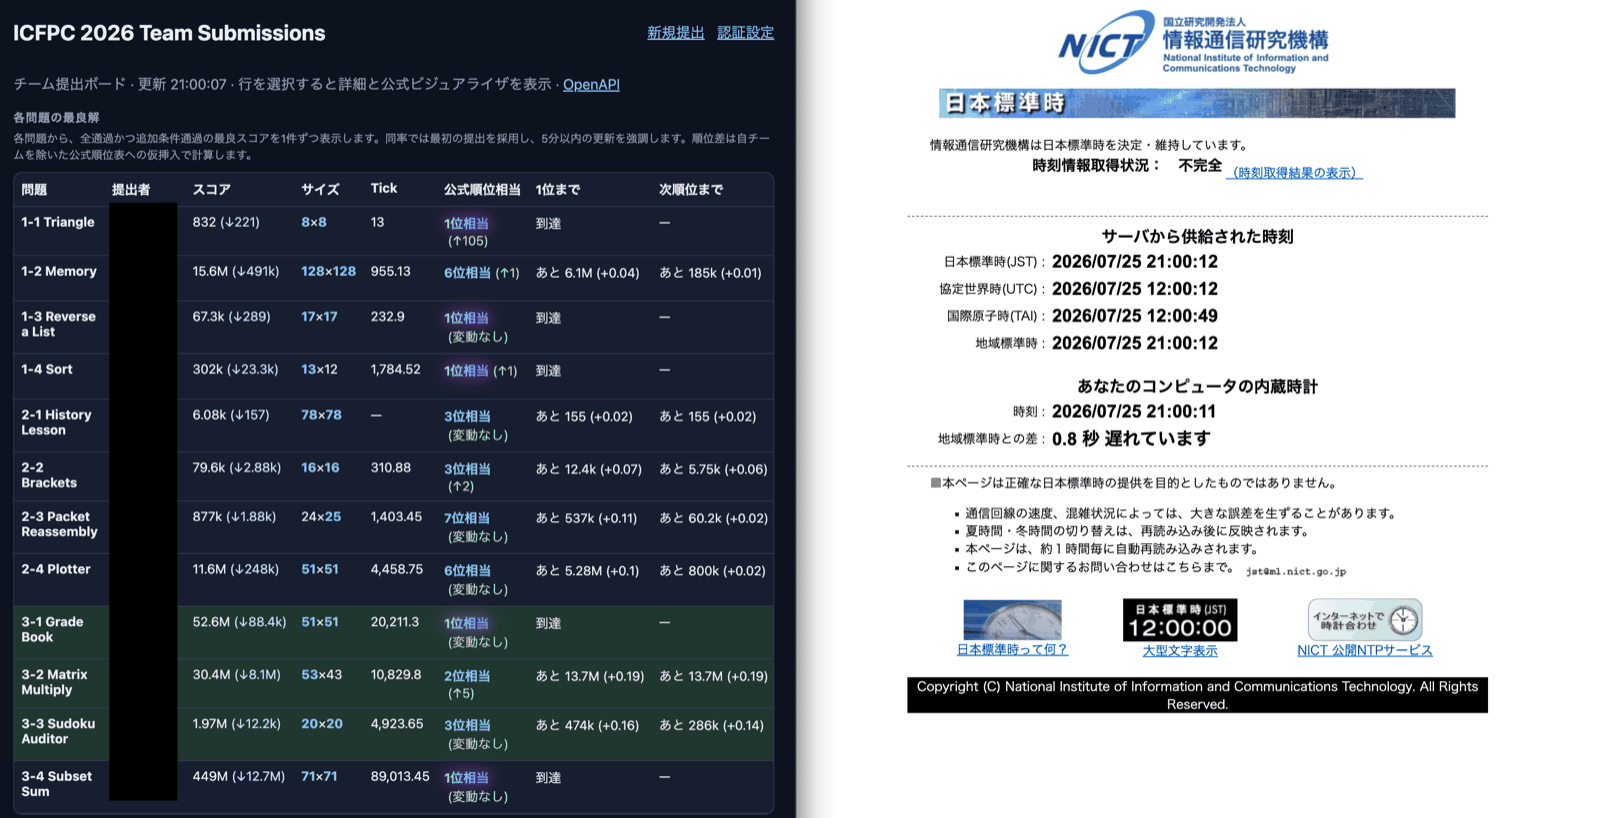
23時に凍結が解除された時点の公式順位表では 3 位でした。21時の Lightning Round 終了と同時に新しい問題が追加されており、この時点の公式順位表には、その新しい問題の得点も含まれていました。新しい問題による得点を除いて考えると、おそらく Lightning Round で1位を取れただろうと皆で予想していました。
Lightning Round 終了後
Lightning Round が終了すると、4つの問題と Y 命令が追加されました。
画面を描画する Snake や Pathfinder、別のプログラムを解釈して実行する問題など、実装する内容も複雑になっていきます。
そのため、前述のコンパイラや、それまで作ってきた共通部品を使い、まず動く解を作ることから始めました。
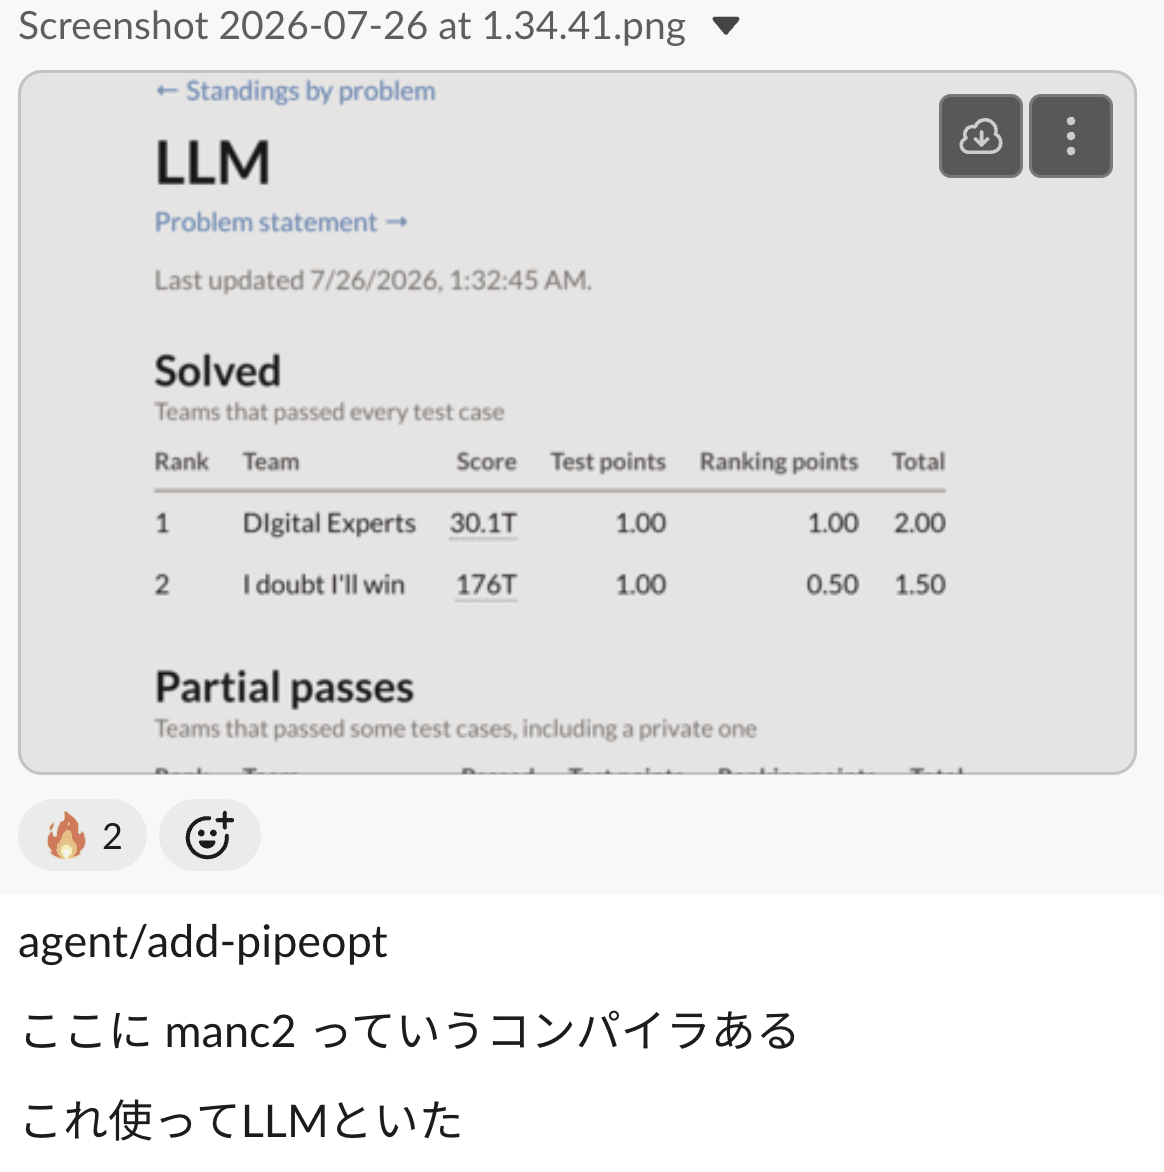
7月26日には、コンパイラを使って問題「LLM」の全テストに合格する解ができました。その後まもなく Pathfinder が解けて全問題の正解が出たため、あとはひたすら改善を進めていくだけになりました。
ちなみに、追加された Y 命令は、前半の問題にも使えます。そのため、前述したように Memory で小人を同じ部屋にまとめたり、Reverse a List で値を持った小人を分裂させて逆順に取り出したりと、これまでの解も見直すことになりました。
全部で16問の改善を行う必要があるため、トークン使用量に加えてコーディングエージェントを動かすPCの限界もあり、うまく問題を分担して取り組んでいく必要性が生まれました。そうなると取り組むメンバーの数も重要なのですが、7月27日は月曜日なので帰るメンバーも多く、全部で15人いた参加者のうち、27日の途中に宿に残っていたのは3人だけになっていました。とはいえ、皆、帰宅後も改善を続けてくれていました。
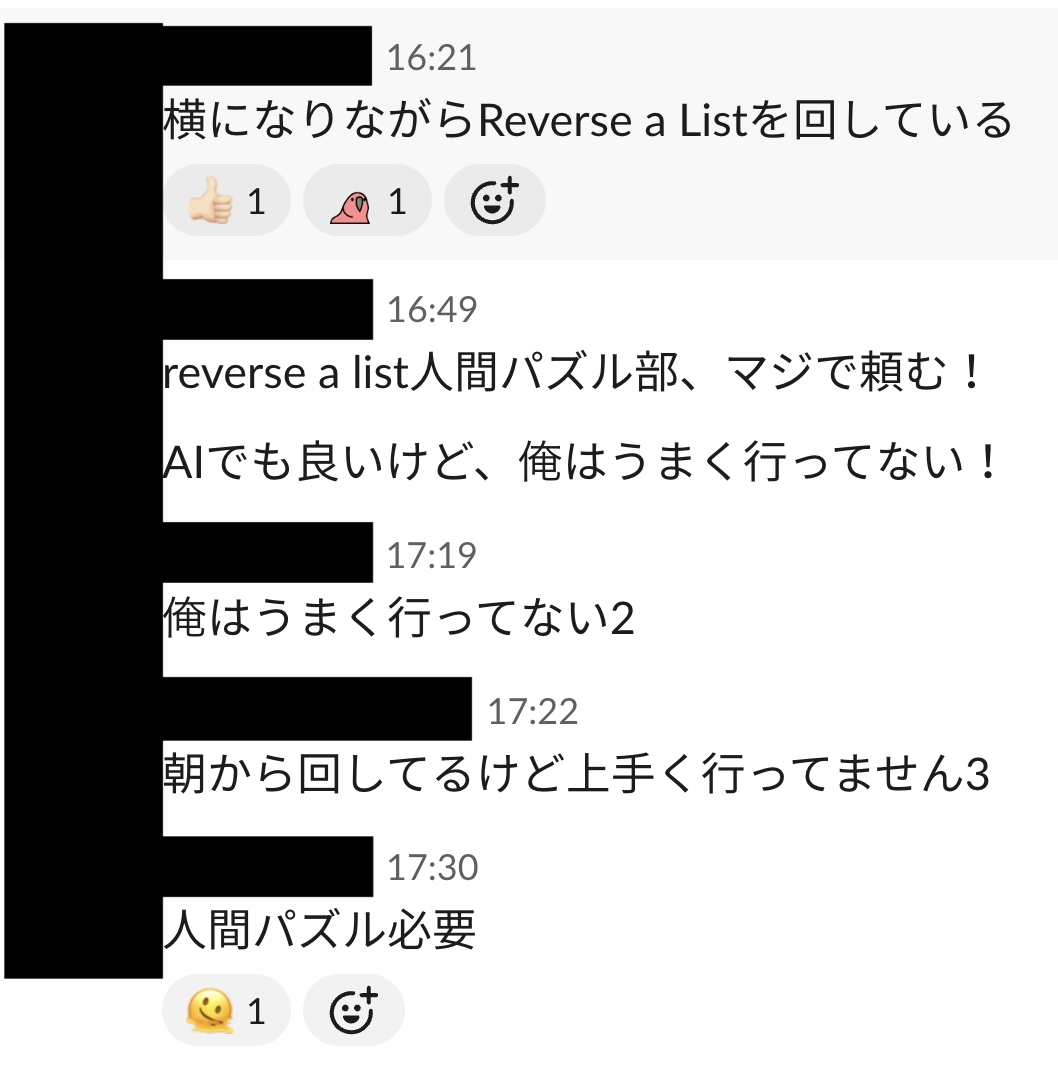
AIを使っての改善はひたすら進めていたのですが、一部の問題はどう頑張っても上位陣に勝てませんでした。特に Reverse a List が厳しく、パズルをする人達が集められました。ですが、あまり改善がうまくいかず、凍結時点で8位相当で終わってしまいました。
最終日の19時になると公式順位表が凍結されました。凍結時点では総合1位でしたが、Lightning Round と同様、それ以降に他のチームがどのくらい改善しているかわかりません。21時のコンテスト終了まで引き続き自分たちの解を改善していきました。
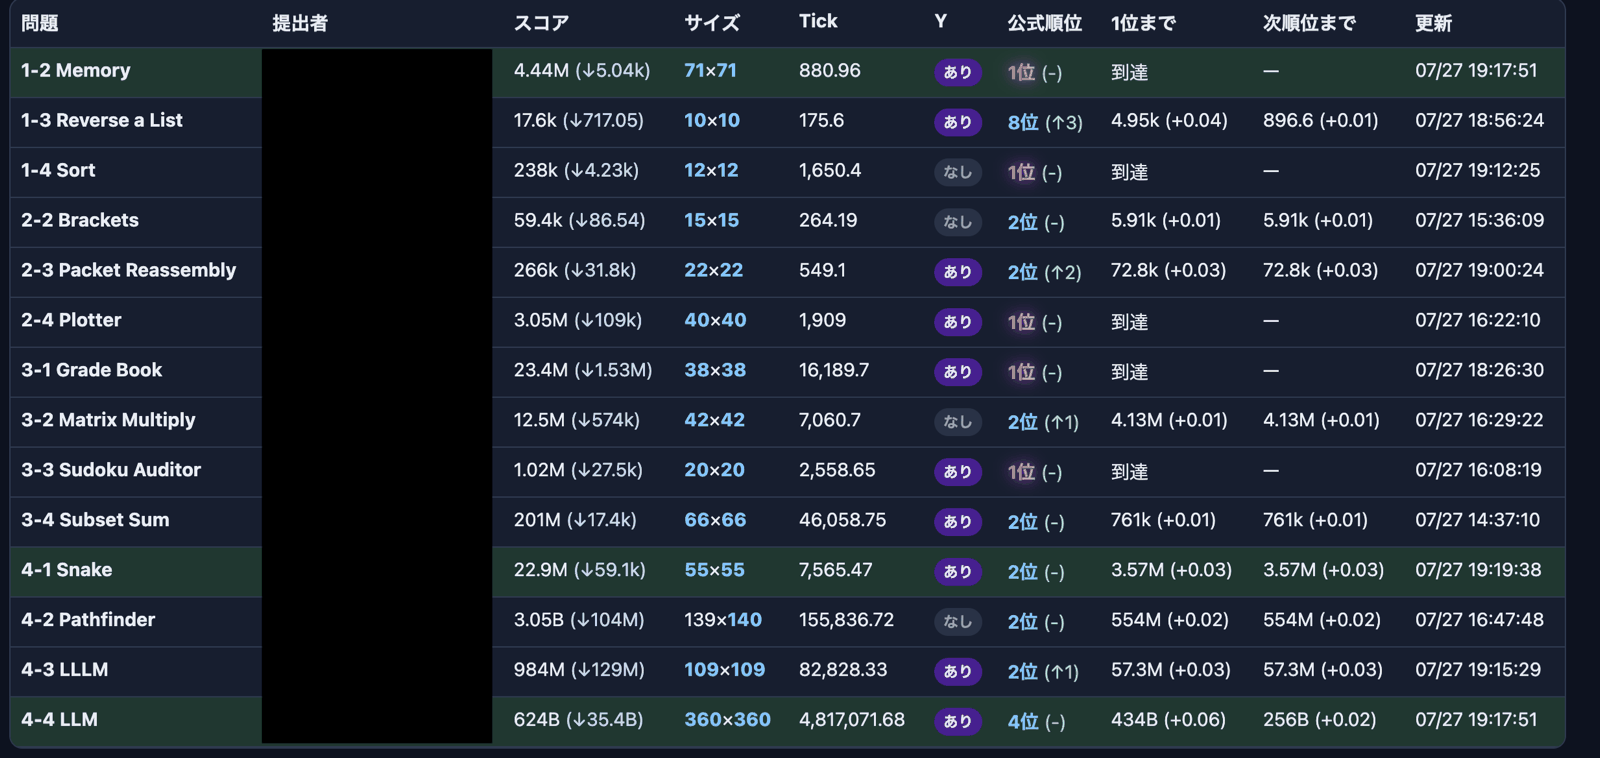
上は凍結直後の提出プロキシの画面です。自チームの解は19時以降の更新も反映した最新のもので、他チームの成績は凍結時点のものです。
後から提出履歴を振り返ると、この最後の2時間に提出した解だけでも 87 件のチームベスト更新がありました。締切直前の20時59分には、LLLM の大きな改善が入りました。 108×108の盤面サイズはそのままで、直前のチームベストからスコアを約17.42%改善することができ、凍結直前に LLLM で1位だったチームのスコアをこれで超えることができました!
こうして72時間のコンテストが終了しました。 そして8月27日、ICFP で Lightning Round と総合の両方で1位だったことが発表されました! 当社のお知らせでも結果を報告しています。
感想・まとめ
冒頭でも触れたように、今年も合宿形式での参加でした。 人によって滞在期間は異なりましたが、コンテスト終了後の1泊を含めた4泊5日で滞在し、社員とインターン生で宿の会議室に集まって作業しました。行き詰まったり、AIが作業をしている間に温泉に浸かったりと、集中とリラックスのバランスをうまく維持して取り組むことができました!
昨年もAIが初期的な解を作ったりと部分的な活躍をしていましたが、今年はAIの重要性が飛躍的に高まり、これまでのICFPCとはまったく異なる競技性になっていたと感じました。今回うまくいったのは、昨年の反省点だった情報共有と環境整備を、AIが使える形で用意できたことです。提出プロキシに残っている提出だけでも2,262件あり、AIが自律的に改善を進められたことがわかります。提出プロキシでの解の共有と次の目標スコアの取得は、改善の質だけでなく量にも特に貢献していたと感じます。
一方で、時間と計算リソースが限られた状況では、人間の役割も重要でした。
Memory の Y 命令を使った構成のように、解き方の方針を人間が決めて、その後の最適化を AI に任せる分担が効果的でした。どの問題にトークンや PC を割り当てるかも、人間が判断することが重要でした。
当時は、ちょうどコンテスト中に Claude Opus 5 がリリースされた時期でしたが、現在はそこからさらに性能が向上したAIモデルがリリースされています。そのため、最適なAIとの協調方法はまた変わっているでしょう。このコンテストでその場その場に応じた効果的なAI活用の必要性をより感じました。また来年 ICFPC が開催されるときには、どのように取り組んだチームが上位を取ることになるのか楽しみです!
結果発表の後には、丸紅株式会社 副社長の及川様に、参加した社員メンバーの祝勝会を開いていただきました。ありがとうございました!
参加した皆さん、お疲れさまでした! そして、コンテストを開催してくださった運営の皆さん、ありがとうございました!
おわりに
今回の ICFPC 参加は会社イベントとして行いました。今後もこうした技術イベントを含め、様々な取り組みを行っていく予定です。
Digital Experts株式会社はインターンシップ・新卒採用・中途採用を積極的に行っています!興味のある方は採用ページをご覧ください。